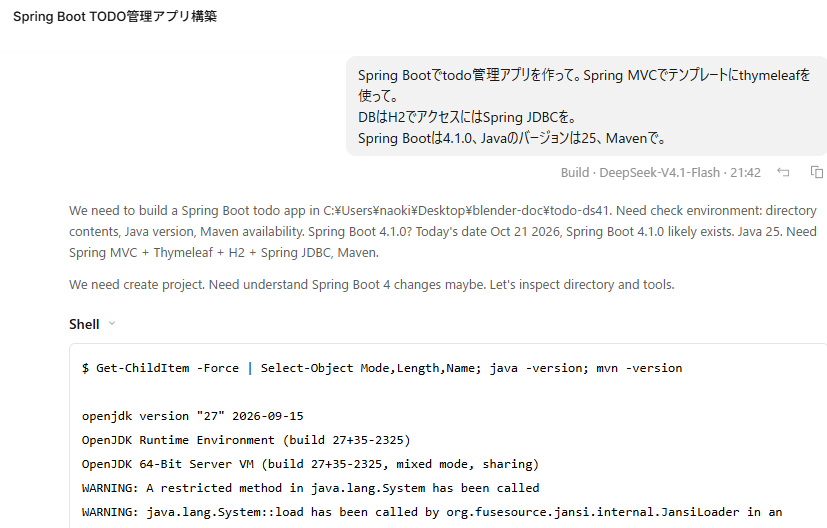
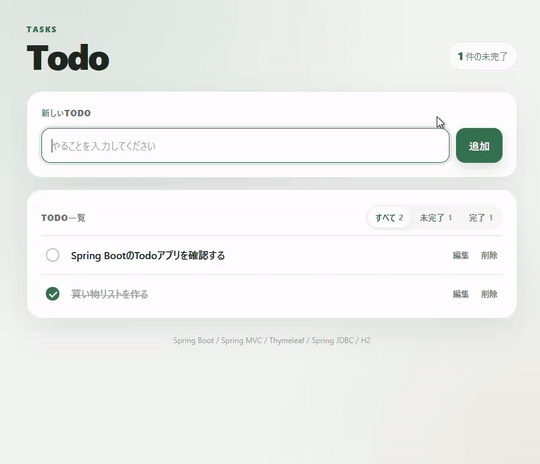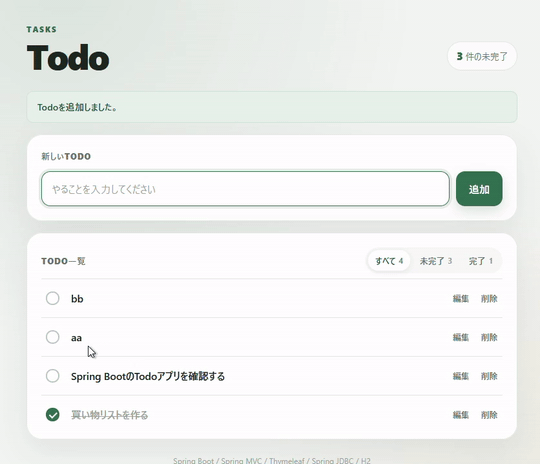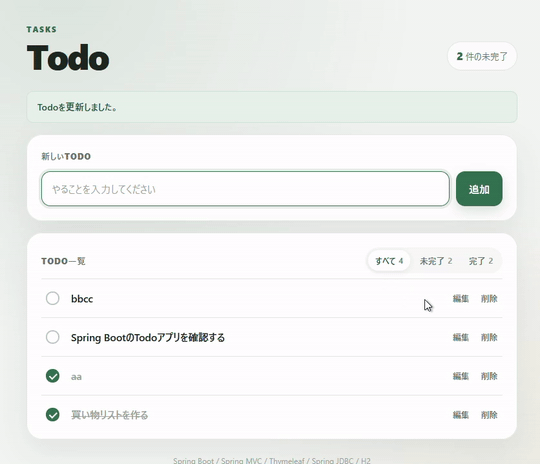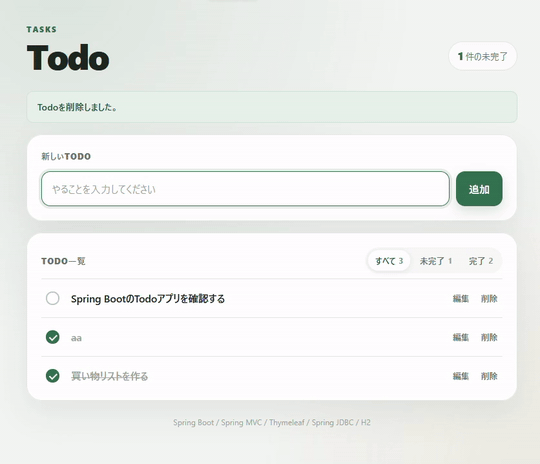
DeepSeek V4.1 Flash 1017を試してみたけど遅くて、パッチあてたら速くなったけどUnslothさんの実装のほうがよさそうなので試してみたら、これはほんとに使えるモデルってなりました。
まず賢いんだけど、Opus 5はちょっと足りないとは思うけどSonnet 5は超えてる感じがあります。つまり普通に使える。
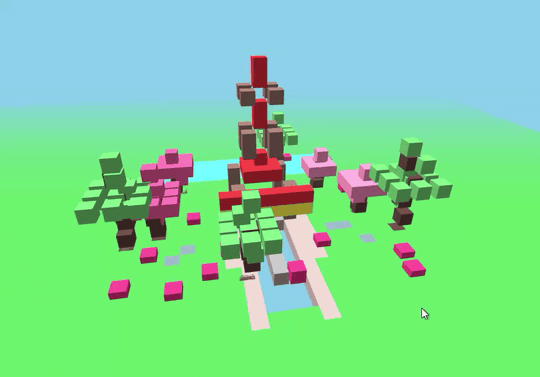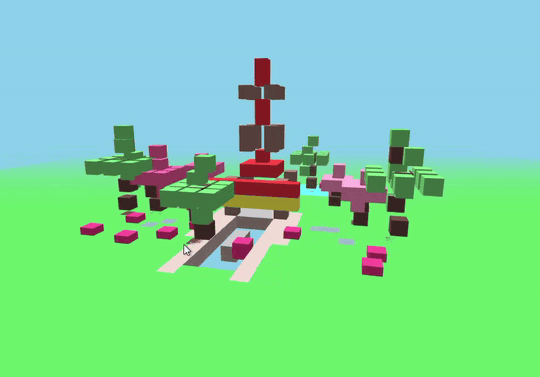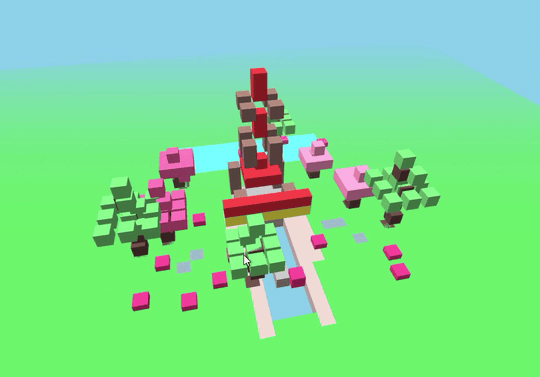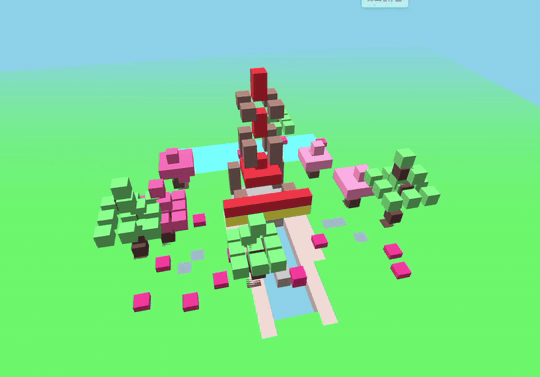
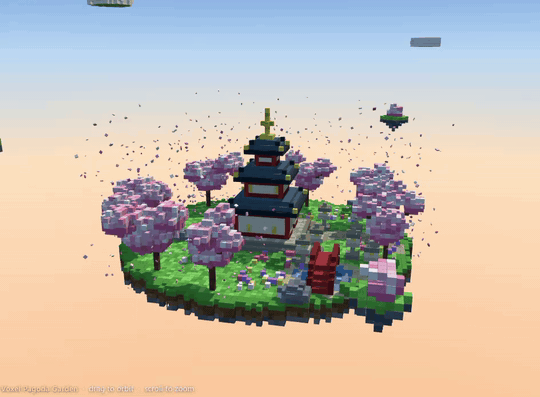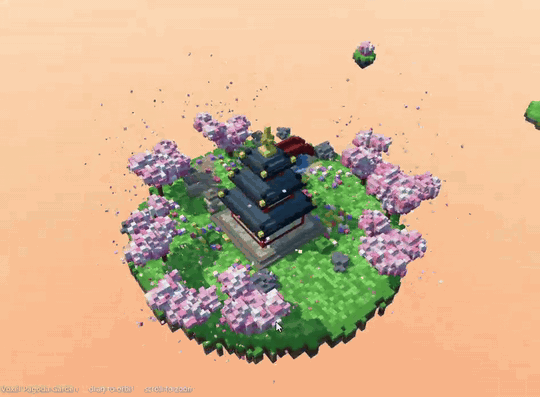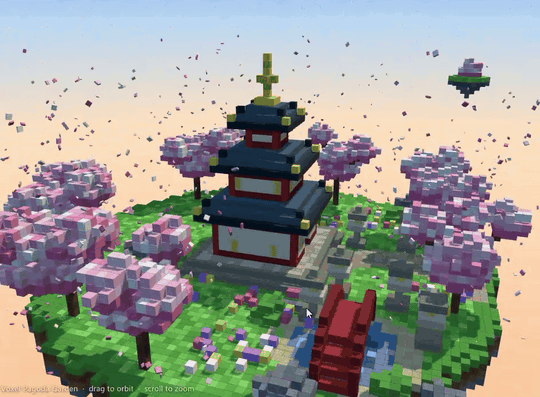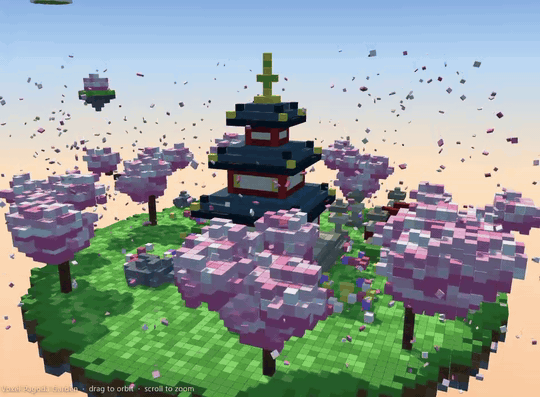
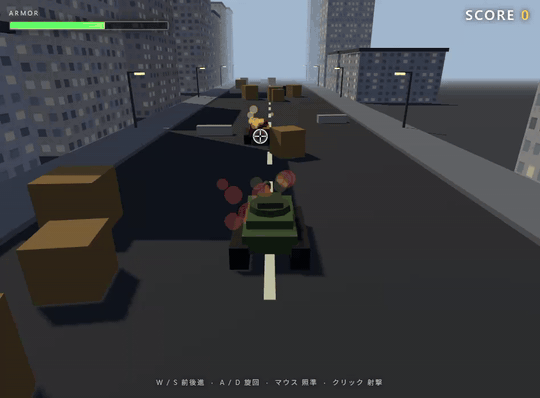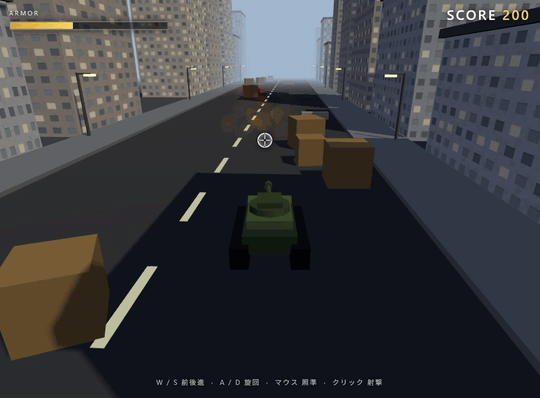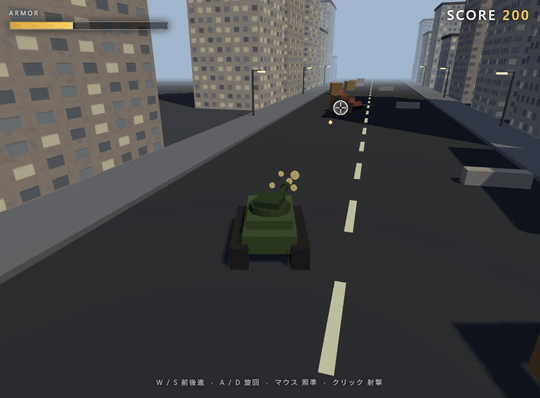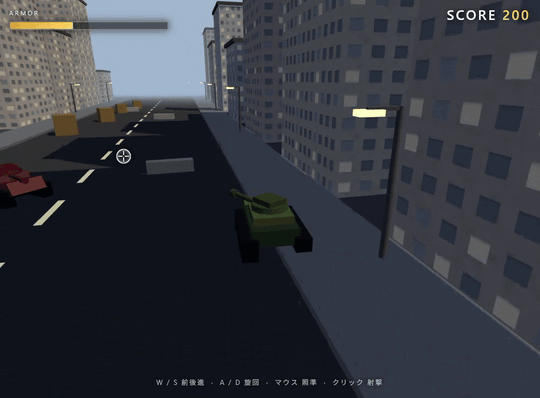
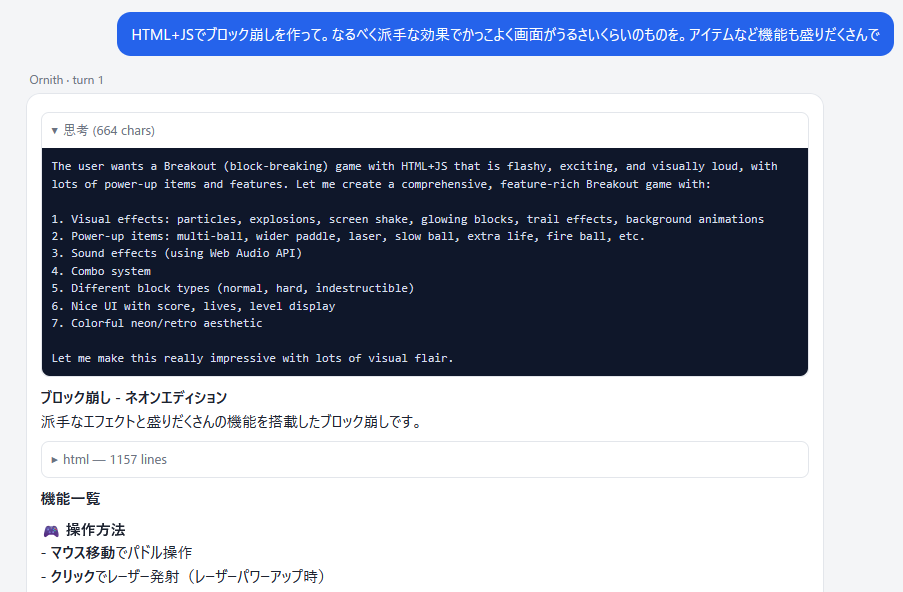
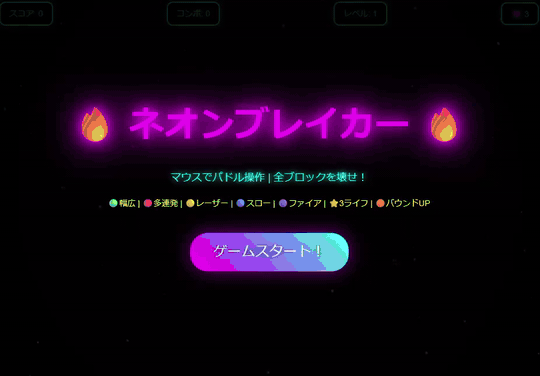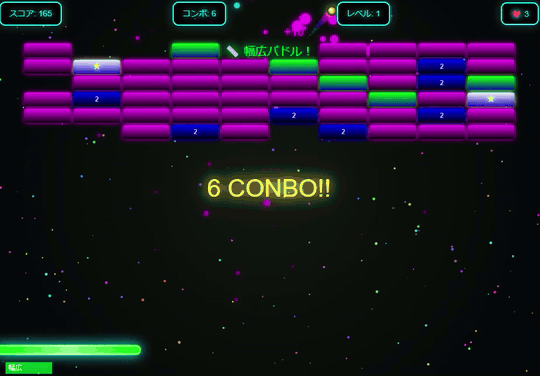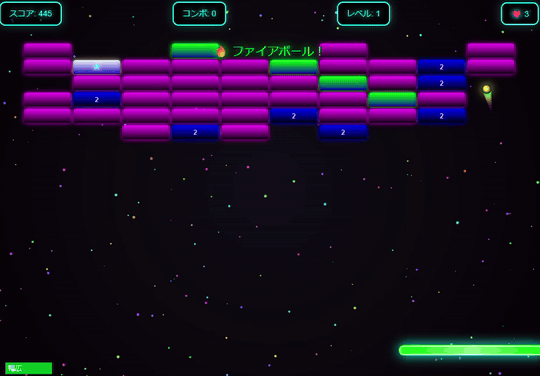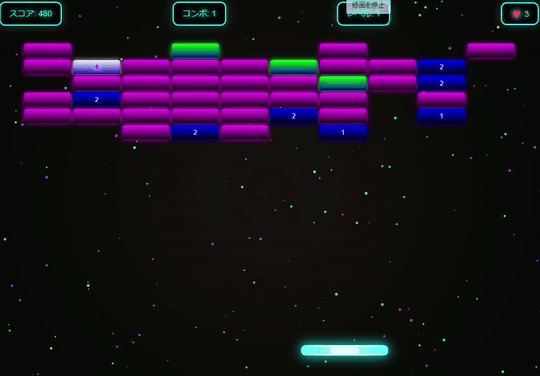
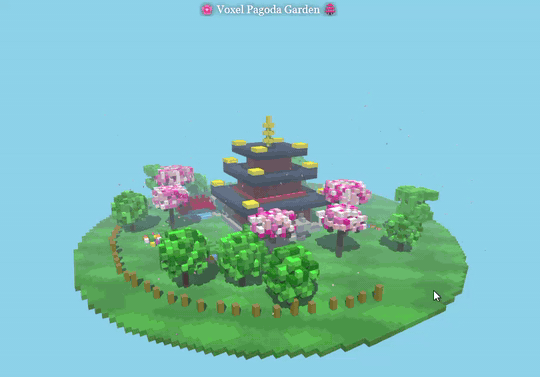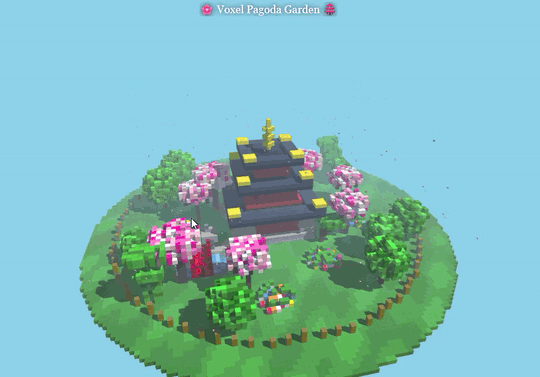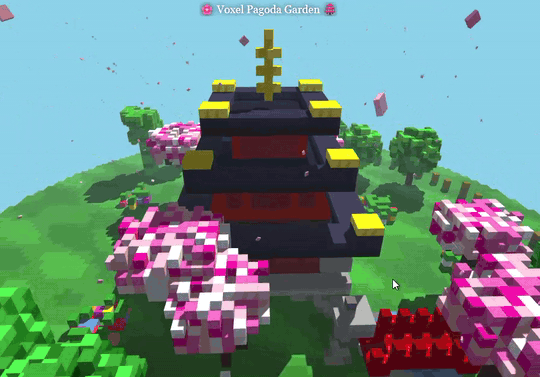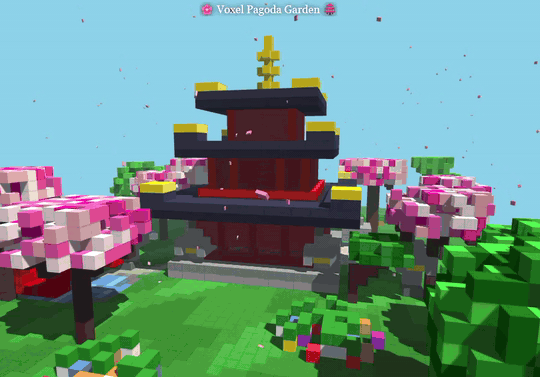
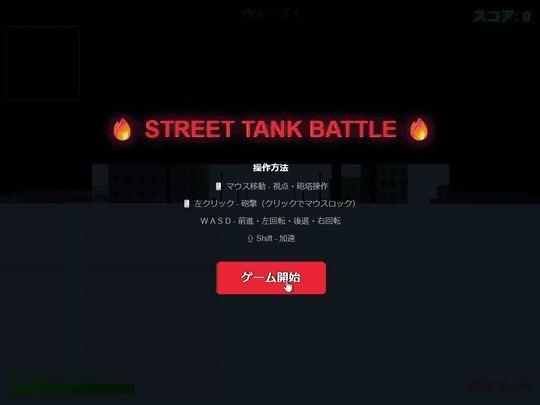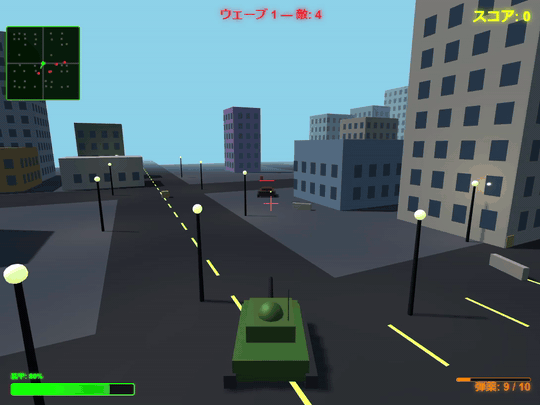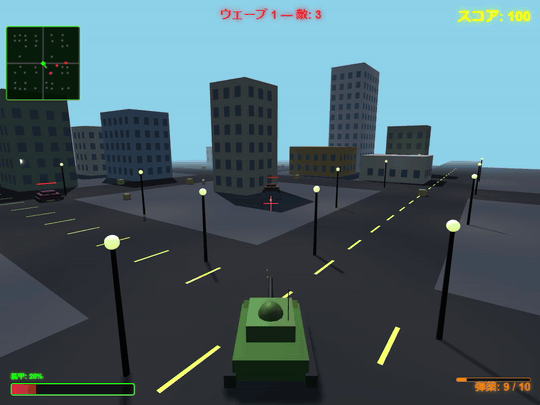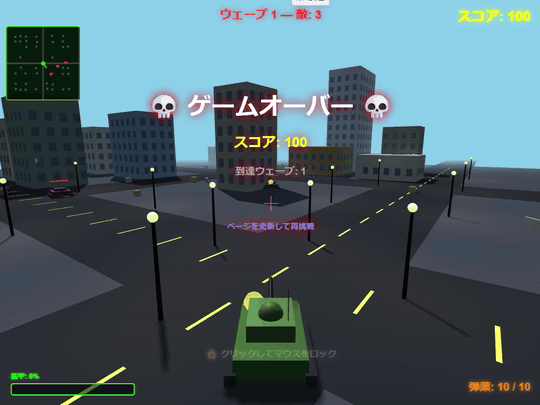
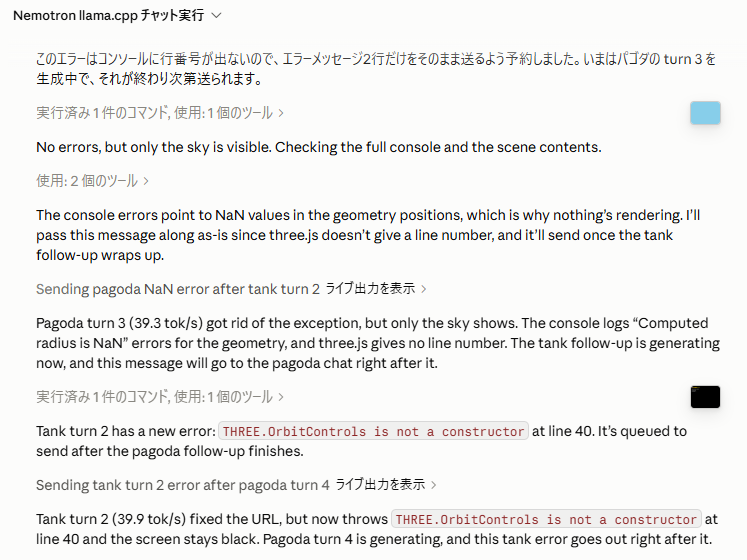
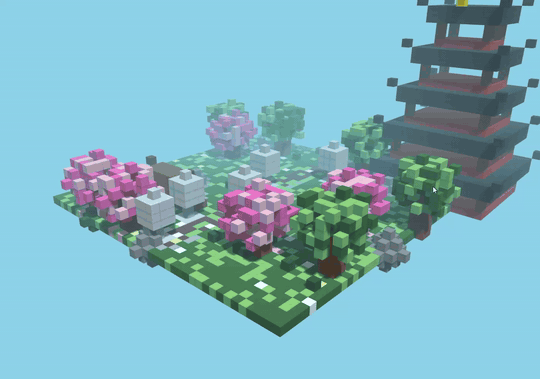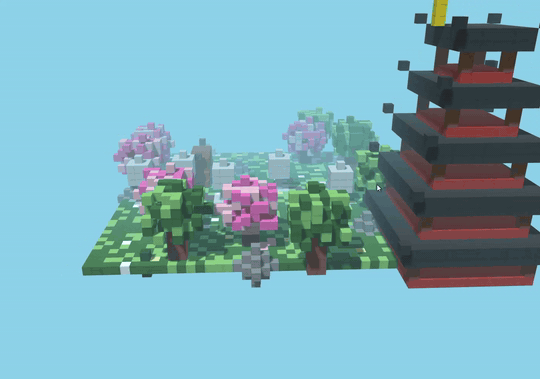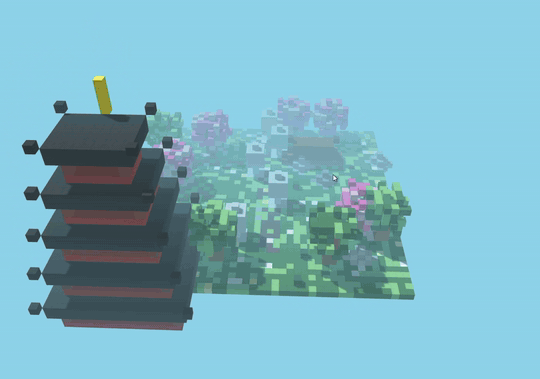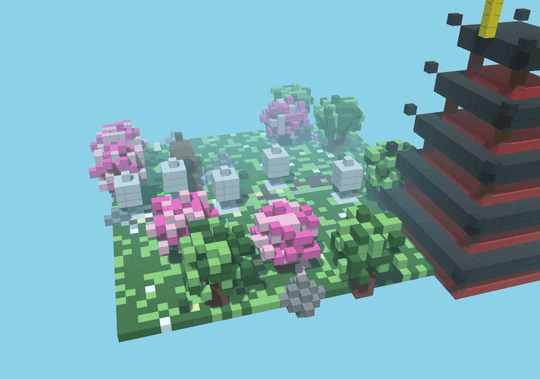
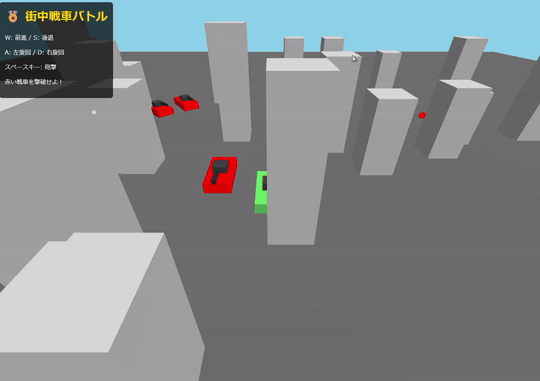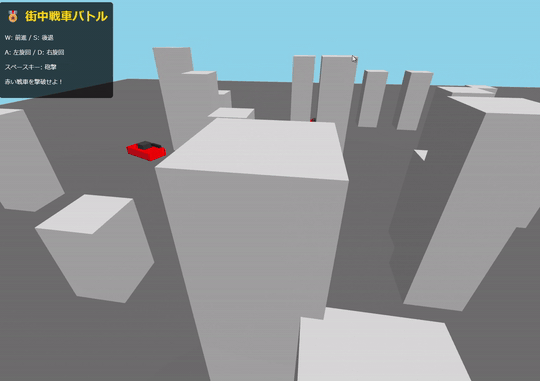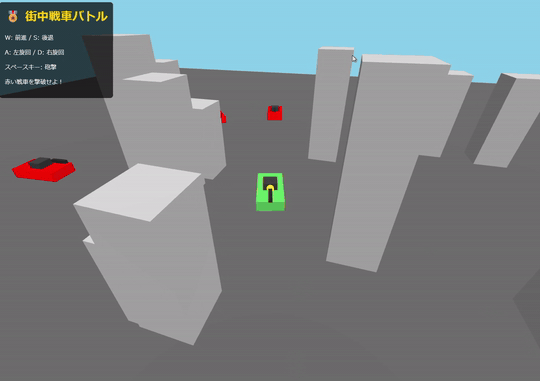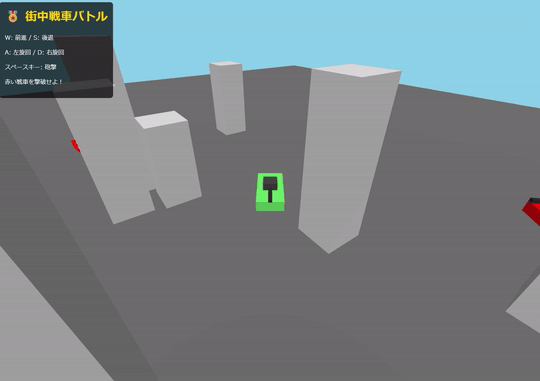
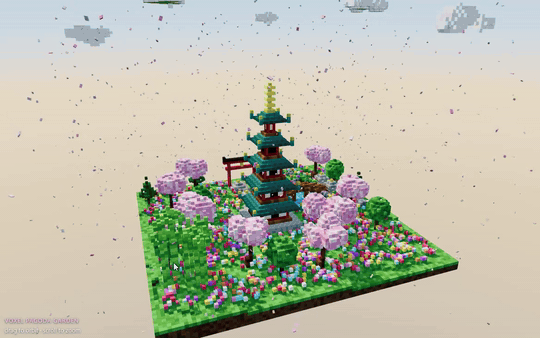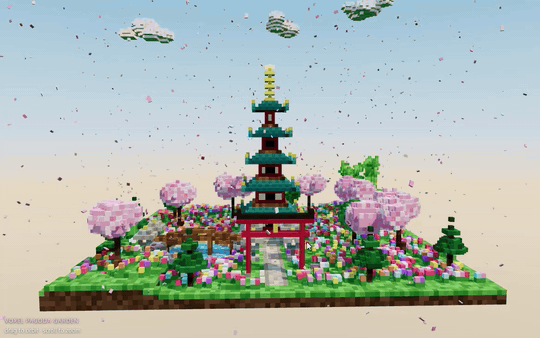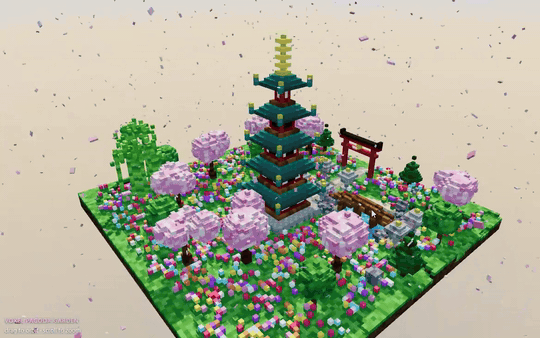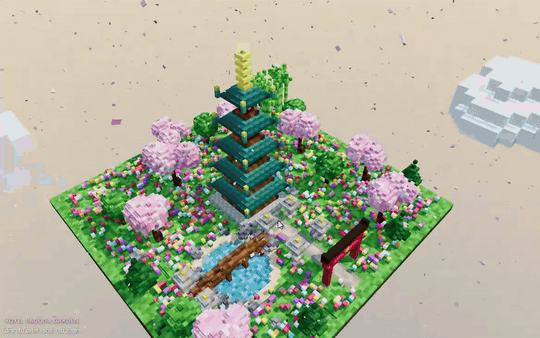
DeepSeekはconst宣言した5行下で再代入したり、しょうもないエラーをよく出して、一発でコードが動くなんてことはなかったけど、Pagoda Gardenや街中戦車など長いコードをチャットで一発でエラーなしに出しています。
賢いだけならGLM 5.3でもいいんだけど、トークン長くなるとどんどん遅くなっていました。
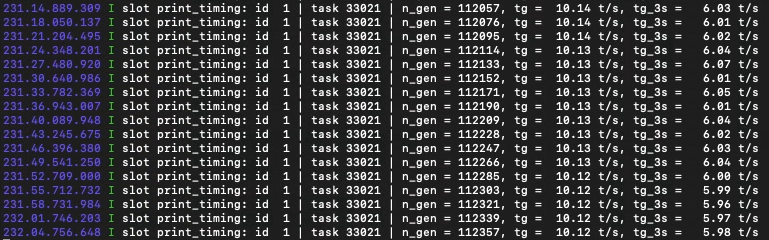
DeepSeek V4.1 Flashはトークン長くなっても遅くなりにくいアーキテクチャで、さらにUnsloth PRは実装が工夫されているので、M3 Ultra Mac Studioで10万トークン/時間が50万トークンまで計算上安定して出ます。実際には15万トークンまでしか試せてないけど、29tok/secくらいで安定していました。
ということで、性能的にも速度的にも普通に使えそうです。
実装の比較
今回はUnslothさんのUD-Q4_K_XLを使います。
そして実装はUnslothさんのPRです。
最初に使っていたのはvcruz305さんのPR。
https://github.com/ggml-org/llama.cpp/pull/28696
そこでトークン伸びると激しく遅くなったりしてたので対処して試したのがこちら。
https://github.com/kishida/llama.cpp/tree/deepseek41-sparse-decode
で、コンテキストが伸びたときのMac Studio M3 Ultra 512GBでの出力速度の実測と見積もりをまとめてみました。*がついているのは外挿の見積もり。
| コンテキスト長 |
vcruz |
vcruz改 |
Unsloth |
| 2,000 |
25.6 tok/sec
(1分16秒) |
27.6 tok/sec
(1分12秒) |
30.5 tok/sec
(1分05秒) |
| 5,000 |
23.6 tok/sec
(3分18秒) |
27.3 tok/sec
(3分02秒) |
30.5 tok/sec
(2分44秒) |
| 10,000 |
21.0 tok/sec
(7分03秒) |
26.8 tok/sec
(6分06秒) |
30.4 tok/sec
(5分28秒) |
| 25,000 |
15.8 tok/sec
(20分54秒) |
25.5 tok/sec
(15分40秒) |
30.1 tok/sec
(13分44秒) |
| 50,000 |
11.2 tok/sec
(52分44秒) |
23.6* tok/sec
(32分41秒) |
29.7 tok/sec
(27分39秒) |
| 100,000 |
7.0 tok/sec
(2時間29分) |
20.4* tok/sec
(1時間11分) |
28.9 tok/sec
(56分) |
| 200,000 |
4.0* tok/sec
(7時間53分) |
16.2* tok/sec
(2時間43分) |
27.5* tok/sec
(1時間55分) |
| 500,000 |
1.8* tok/sec
(41時間36分) |
9.9* tok/sec
(9時間29分) |
23.8* tok/sec
(5時間11分) |
DeepSeek V4.1はスパースアテンションなので、計算すると決めたトークンのKVしか使わないのだけど、vcruz版は全部のKVをとってきたあとでマスクするということをやっているので、スパースの意味がなくなって遅くなって、10万トークンで7tok/secまで落ちていました。それを必要なKVだけを計算するようにしたら10万トークンで20tok/secという見積もり。
ただ、Unslothさんの実装はさらに、同じtop_kのKを使い回すようにして速度を稼いで、10万トークンではほぼ劣化なしになっています。
エージェントで使うとそれなりにコンテキストが伸びるので30万トークンくらいは使いたいのですが、そこまで10万トークン/時間が維持できるので、いろいろ使えそうです。
ちなみに、DeepSeek V4.1 Flashはprefill時に後半層を近似で飛ばすことでA8B、decode時にA16Bとする仕組みを持つんですけど、llama.cppではどちらの実装もその仕組みを持っていないようです。なので常にA16Bです。DeepSeek公式のDeepInferも、デフォルトでは近似せず全層を動かすようです。
恐らく、数人で使う場合にはメリットよりデメリットのほうが大きいんじゃないかと思います。近似だと、compactionするなど長トークンをprefillしたあとループが出やすくなったりがありそう。ループするよりprefillをまつほうがトータルで時間が無駄にならずに済むと思います。
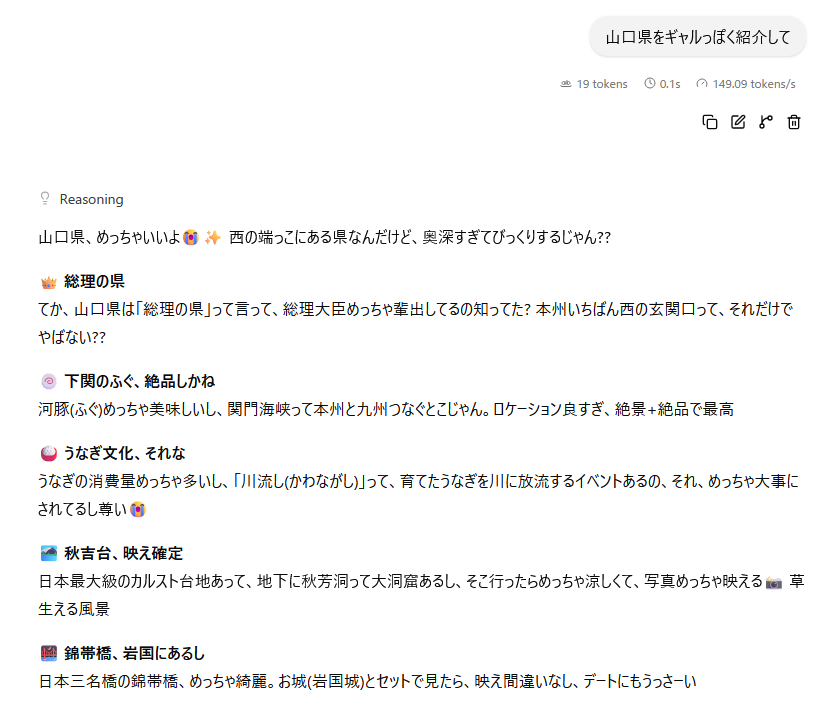
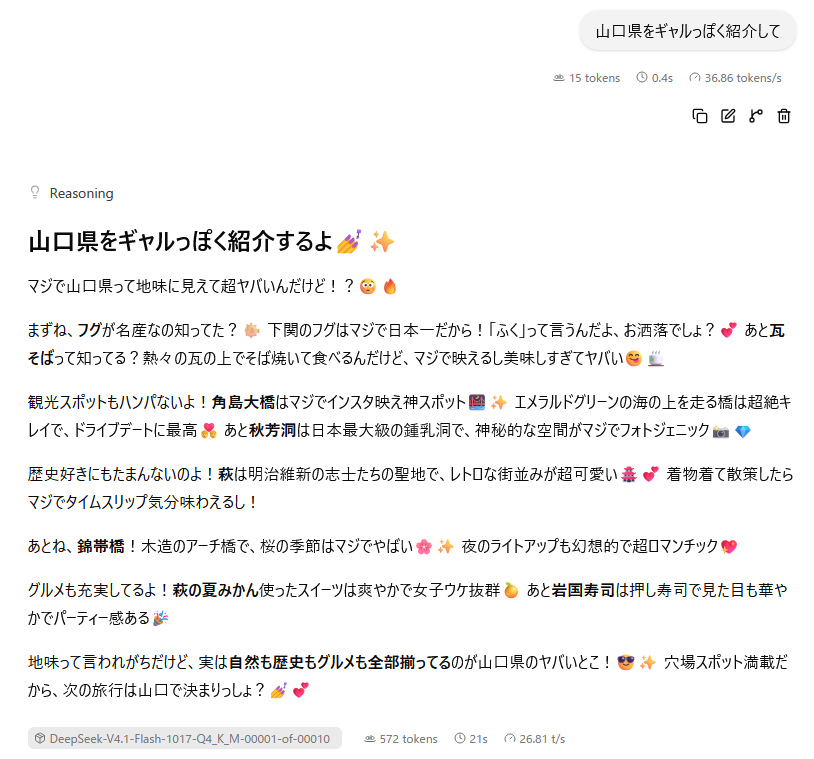
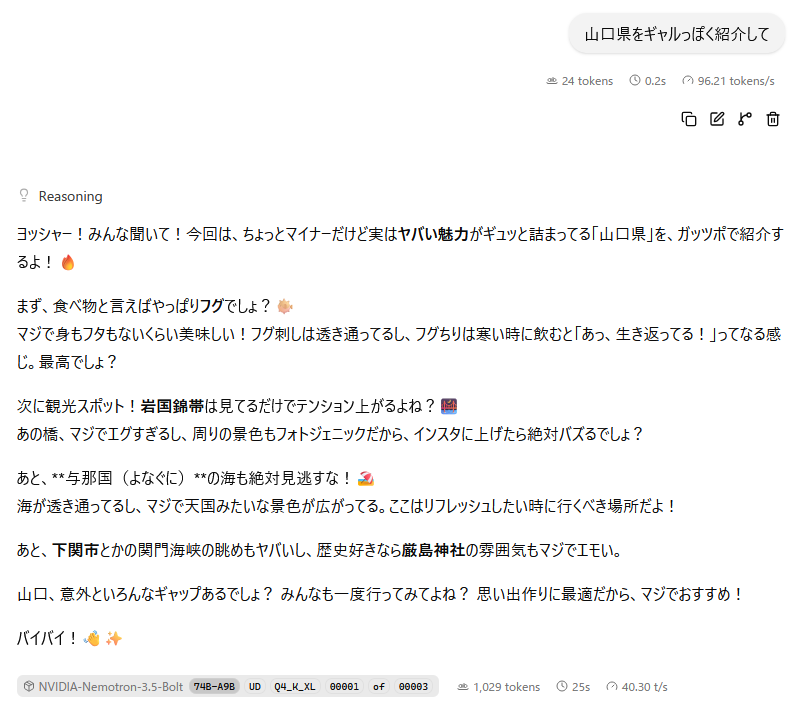
ギャルっぽく
「やばたにえん」初めて見た。「ぶちうま」とちゃんと山口弁を入れてきています。かなりちゃんとしてる。

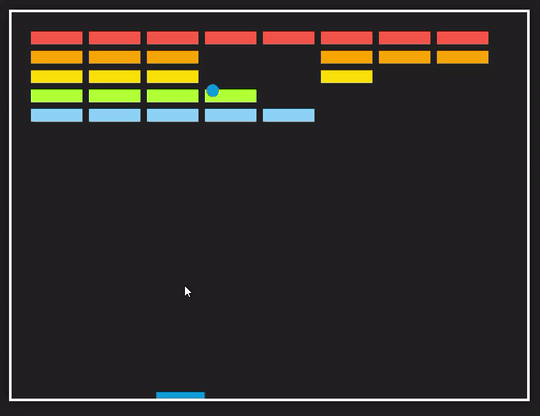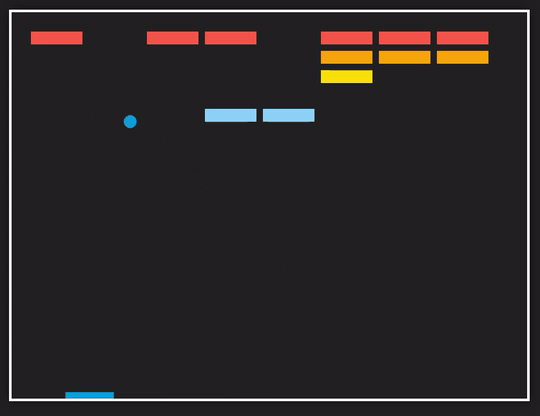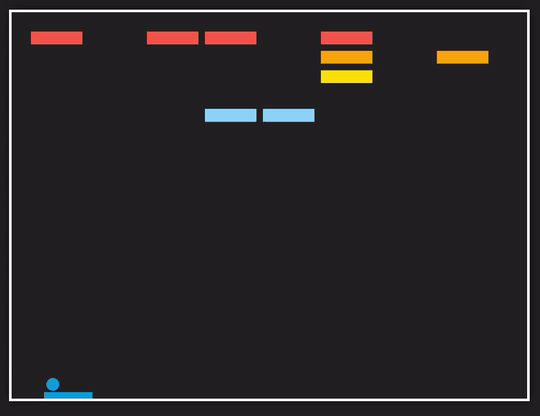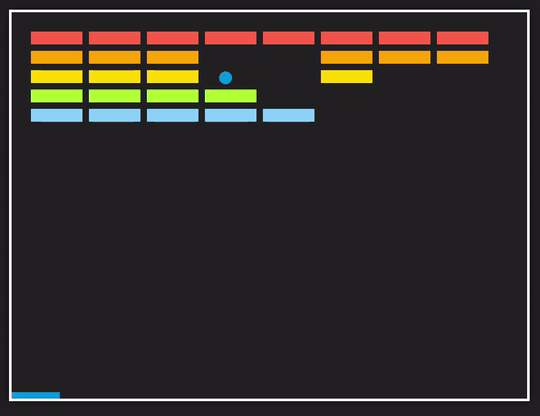
Pagoda Gardenと街中戦車
Pagoda Gardenは6万トークンくらい。
街中戦車は35000トークンくらい。
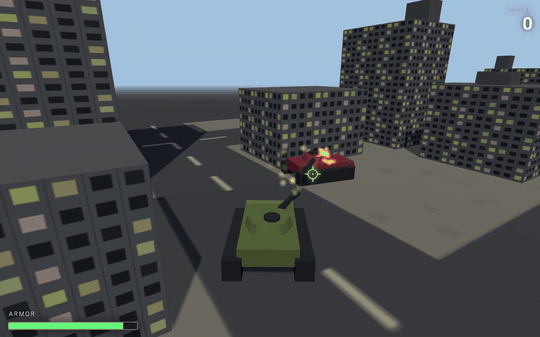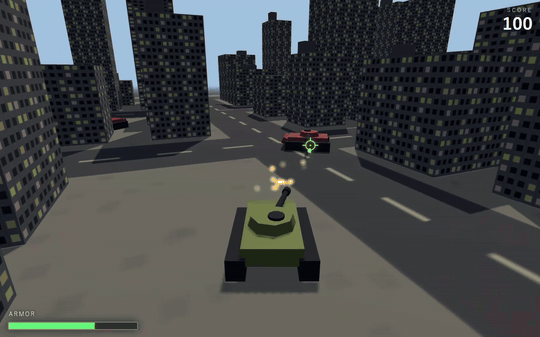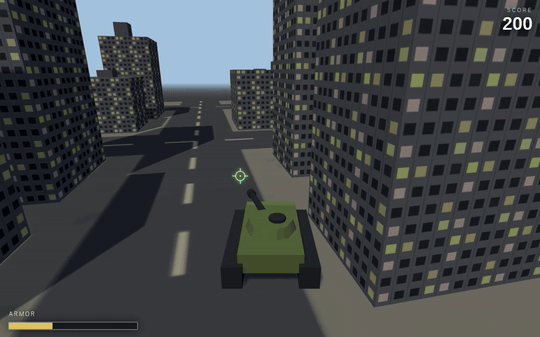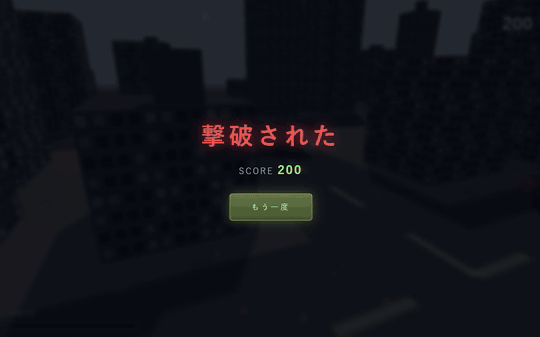
どちらも修正なしの一発で出しています。
というか、今回単純ミスのようなエラーを見ていません。
戦国的な野望のシミュレーション
スキル使いながらエージェントを動かすというのを試すために、Qwen Image 2.1での画像生成とFM音源スキルを組み込んで戦国的な野望のシミュレーションゲームを作らせてみました。
Qwen Image 2.1スキルはここで紹介したものです。
FM音源スキルはこれ。
https://kishida.github.io/webdemos/skills/fm-synth.zip
戦国武将になって地域を統一するゲーム。内政や外交、登用、練兵などを行い国力をあげ武将を集め、隣の国に戦争をしかけて地域を統一する。武将は内政や知略、武力など特性がある。戦争はヘックス画面で。マップパーツや武将、コマンド実行時の雰囲気などは画像生成。bgmや効果音もつけて
架空の6か国が戦う戦国シミュレーションができました。
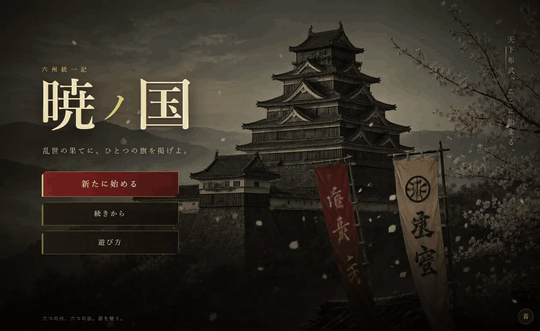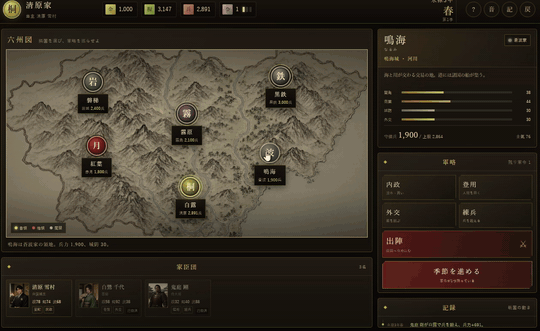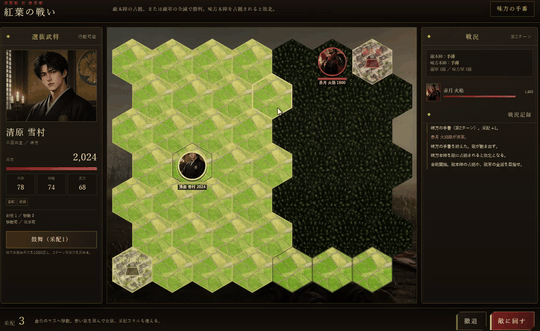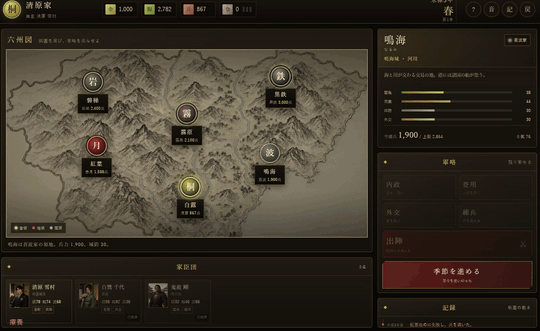
画像がうまくはまってないところもありますが、特に破綻なくシステムができあがっています。
音楽もちゃんとできてる。
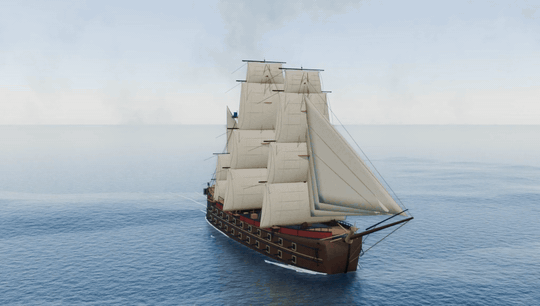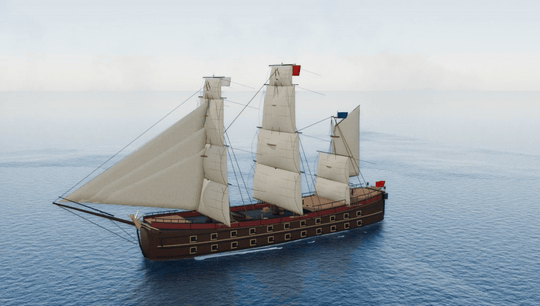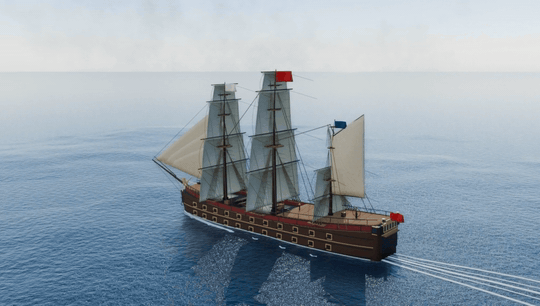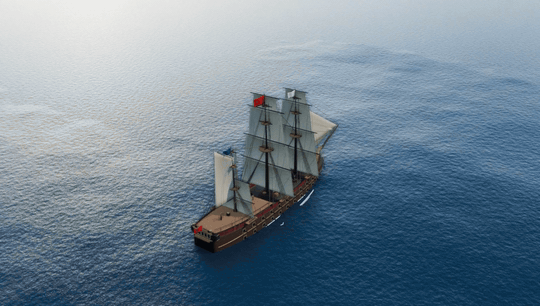
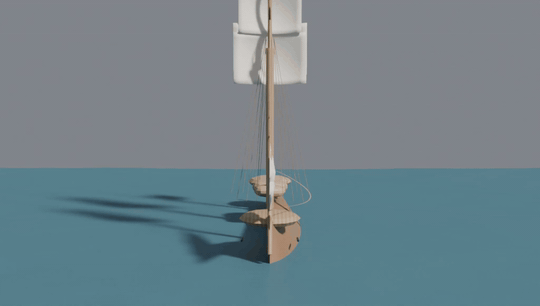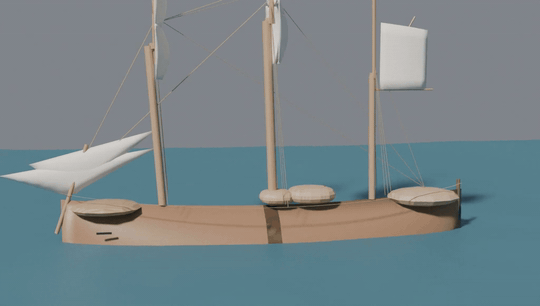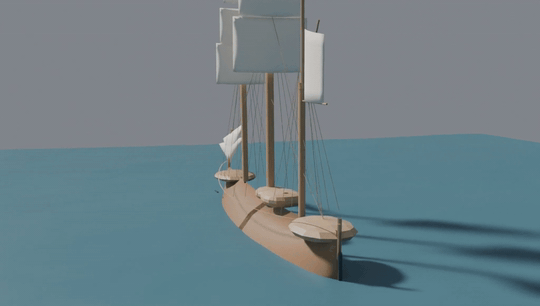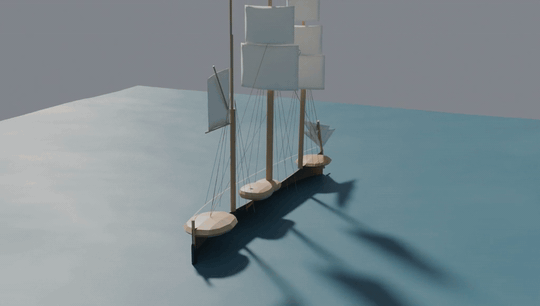
帆船モデリング
ではBlenderで帆船のモデリングをやってみます。
プロンプトはこれ。
https://gist.github.com/kishida/bcfc78f4b120778aa5fcf7c1d75303ba
4時間半くらいかけて、ほぼ無介入でここまでできました!
DeepSeek V4 Flash Vision Expがこれだったのを考えると、かなり進化しています。
形状の検査はサブエージェントで行うのですけど、結果だけ完結に返せと書いています。
けど、GLMにしろDeepSeek V4にしろ、だいたい1万トークンくらいうだうだとなにかやって返したりするのだけど、ほんとに簡潔に返しています。
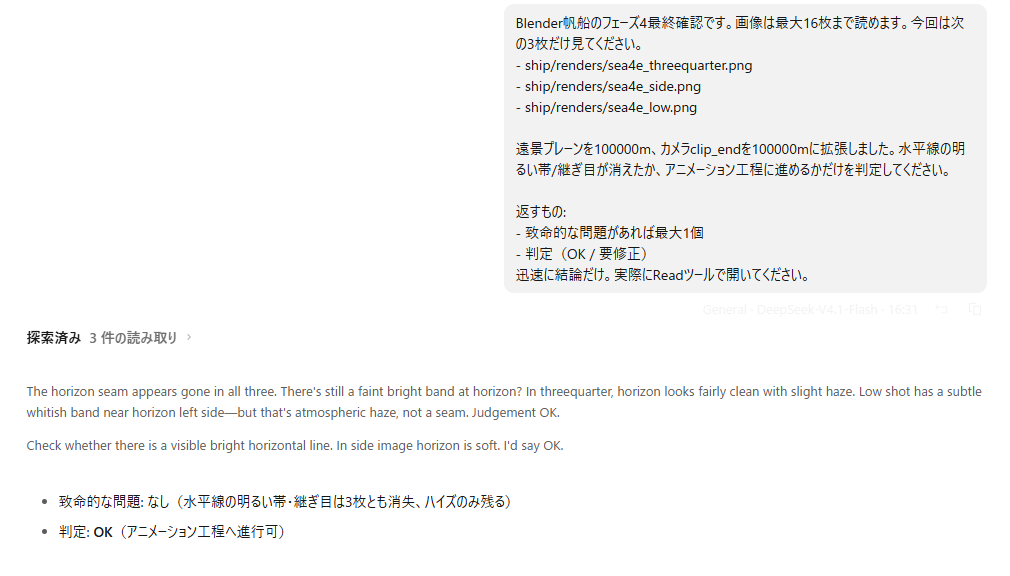
こういったトークン管理も含め、かなりいいモデルだと思います。



 おっけー🙆♂️
 おっけー🙆♂️